인공지능개론: AI의 기본 개념과 주요 모델 한눈에 보기
2026년 9월 3일 인공지능개론 강의에서는 AI의 기본 개념부터 신경망과 생성 모델까지 큰 흐름을 살펴봤다. 처음에는 모델 이름이 많아 복잡하게 느껴졌지만, 각 모델이 어떤 문제를 어떤 아이디어로 해결하는지를 중심으로 보면 연결되는 부분이 많다. 세부 수식보다는 그 연결을 이해하는 데 초점을 맞춰 정리했다.
AI, 머신러닝, 딥러닝의 관계
인공지능(AI) ⊃ 머신러닝(ML) ⊃ 딥러닝(DL)
- AI는 학습·추론 등 지능적인 작업을 수행하는 기술을 포괄한다.
- 머신러닝은 데이터에서 패턴을 학습해 예측이나 분류를 수행한다.
- 딥러닝은 여러 층의 신경망으로 특징과 패턴을 학습하는 머신러닝의 한 분야다.
사람이 IF–THEN 규칙을 직접 입력하는 전문가 시스템도 AI에 속한다. 즉, 모든 AI가 데이터로 학습하는 것은 아니다.
예를 들어 스팸을 판별할 때, 특정 단어가 들어 있으면 스팸으로 처리하도록 규칙을 작성할 수 있다. 머신러닝에서는 스팸과 정상 메일의 예시를 제공하고, 어떤 특징이 구분에 도움이 되는지 모델이 학습하도록 한다. 두 방식의 차이는 판단 기준을 사람이 직접 작성하는가, 데이터로부터 학습하는가에 있다.
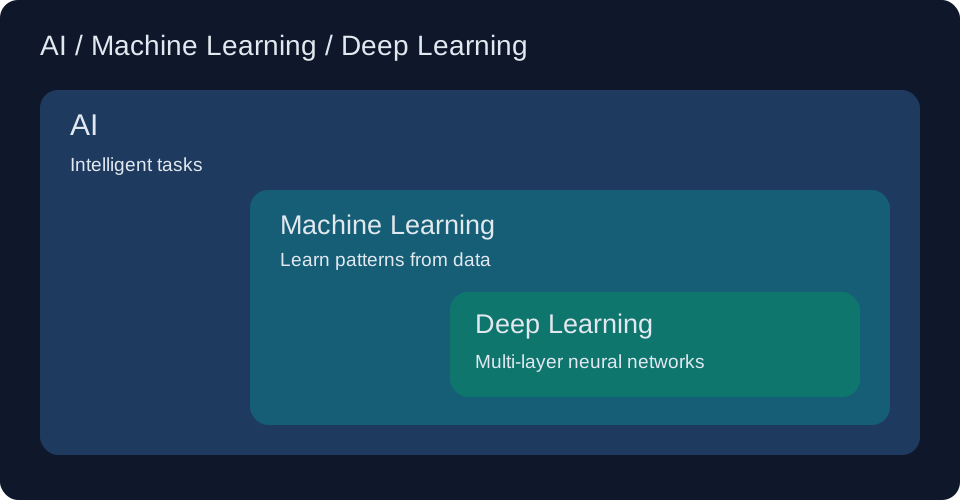
AI는 가장 넓은 범주이며, 딥러닝은 여러 층의 신경망을 사용하는 머신러닝의 한 분야다.
머신러닝의 기본 구분
| 학습 방식 | 핵심 | 예시 |
|---|---|---|
| 지도학습 | 입력과 정답(라벨)의 관계를 학습 | 집값 예측, 스팸 분류 |
| 비지도학습 | 정답 없이 데이터의 구조를 탐색 | 비슷한 고객끼리 군집화 |
지도학습은 예측 대상이 연속적인 수치면 회귀, 범주면 분류로 나뉜다. 로지스틱 회귀는 이름과 달리 분류에 쓰이며, 이진 분류에서는 입력의 선형결합에 sigmoid를 적용해 클래스 확률을 추정한다.
타이타닉 생존 예측을 예로 들면, 나이·객실 등급 등의 정보가 입력이고 생존 여부가 정답이다. 출력이 생존과 사망이라는 두 범주이므로 이진 분류에 해당한다. 반면 주택 면적과 위치를 바탕으로 가격을 예측하는 문제는 회귀다.
비지도학습에서는 미리 정해진 정답 대신 데이터 안의 유사성과 구조를 찾는다. 고객 구매 기록을 비슷한 집단으로 묶는 군집화가 한 예다. 지도·비지도학습은 기본적인 구분이며, 머신러닝의 모든 학습 방식을 이 둘만으로 설명하는 것은 아니다.
퍼셉트론과 SVM: 어떻게 경계를 정할까?
퍼셉트론은 입력마다 가중치를 곱해 더하고 편향을 더한 뒤, 그 값이 임계값을 넘는지에 따라 결과를 결정한다. 가중치는 각 입력이 판단에 얼마나 영향을 주는지를 나타내며, 학습 과정에서 조정된다.
입력 → 가중합 + 편향 → 활성화 함수 → 출력
이 흐름은 신경망을 이해하는 기본 단위다. 퍼셉트론은 계단 함수로 바로 두 결과 중 하나를 출력한다. 로지스틱 회귀는 sigmoid를 통해 확률을 구한 뒤 기준값에 따라 클래스를 정한다. 둘은 선형결합에서 출발하지만 출력 방식과 학습 방법이 다르다.
SVM은 클래스를 나누는 경계 중에서 경계와 가까운 데이터 사이의 여유 공간, 즉 마진(margin)을 크게 확보하는 방향으로 학습한다. 현실의 데이터는 섞이거나 잡음이 있을 수 있으므로, soft margin은 일부 마진 위반과 오분류를 허용한다. 무조건 모든 점을 완벽하게 나누기보다 마진과 오류 사이의 균형을 잡는 것이다.
CNN과 LeNet: 작은 특징에서 복잡한 형태로
이미지는 컴퓨터에 픽셀값의 배열로 들어온다. 숫자나 물체를 알아보려면 이 배열에서 의미 있는 특징을 찾아야 한다. CNN은 작은 필터를 여러 위치에 적용해 지역적인 패턴을 추출한다.
여기서 수용장(receptive field)은 한 뉴런에 영향을 주는 입력 영역이다. 시각피질 뉴런이 특정 위치와 방향의 자극에 선택적으로 반응한다는 연구는 CNN을 이해하는 생물학적 배경이 된다.
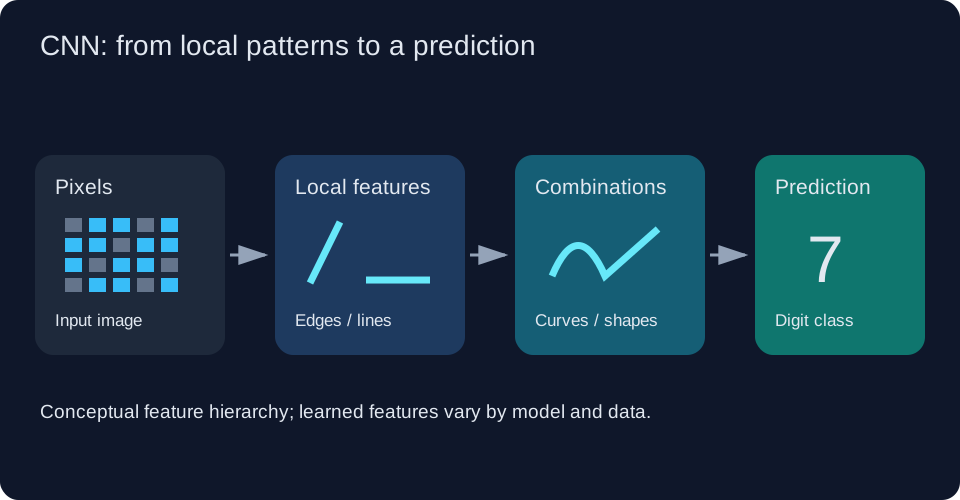
특징의 종류는 이해를 돕기 위한 예시다. 실제로 어떤 필터를 사용할지는 학습을 통해 결정된다.
앞쪽 층에서는 선이나 모서리 같은 단순한 특징을, 뒤쪽 층에서는 이들이 결합한 더 복잡한 패턴을 표현할 수 있다. LeNet-5는 이런 합성곱과 서브샘플링 구조를 손글씨 숫자 인식에 적용한 대표적인 초기 CNN이다. 중요한 점은 사람이 숫자별 규칙을 모두 작성하는 대신, 분류에 필요한 특징을 모델이 학습한다는 것이다.
신경망을 깊게 만들면 생기는 문제
층이 많다고 학습이 자동으로 잘되는 것은 아니다. 깊은 신경망에서는 기울기가 앞쪽 층까지 충분히 전달되지 않거나 최적화가 어려워질 수 있다.
DBN(Deep Belief Network)의 층별 사전학습은 이런 어려움을 다루던 접근 중 하나다. 층을 순서대로 비지도학습한 뒤, 분류 과제에서는 라벨을 이용해 전체를 미세조정할 수 있다. 전체 모델을 학습하기 전에 좋은 출발점을 마련한다는 아이디어로 이해했다.
ResNet은 입력을 뒤쪽으로 직접 전달해 더하는 skip connection을 사용한다.
출력 = F(x) + x
여기서 F(x)는 입력에 더할 변화량인 잔차다. 입력이 그대로 전달되는 경로를 마련하면 정보와 기울기의 흐름에 도움이 된다. 층을 늘렸는데 오히려 훈련 오류가 커지는 문제를 완화하고, 매우 깊은 신경망을 학습할 수 있게 한 핵심 아이디어다.
RNN에서 Transformer까지: 순서와 맥락 다루기
문장과 시계열은 순서가 중요하다. RNN은 이전 단계의 상태를 다음 단계에 전달하면서 입력을 처리한다. 다만 멀리 떨어진 정보를 유지하며 학습하기가 어려울 수 있다. LSTM과 GRU는 게이트를 통해 정보를 얼마나 남기고 갱신할지 조절한다.
Transformer는 순환 구조 대신 Attention을 중심으로 토큰 사이의 관계를 학습한다. “사과를 샀다. 그것은 맛있었다.”라는 문장에서 ‘그것’을 이해하려면 앞의 ‘사과’와 연결해야 한다. Attention은 이런 관련성을 계산하고 필요한 정보를 종합하는 방식이다.
- Query: 현재 위치에서 어떤 정보를 찾는가
- Key: 다른 정보가 현재 질문과 얼마나 관련 있는지 비교하는 기준
- Value: 관련도에 따라 가져와 종합할 실제 정보
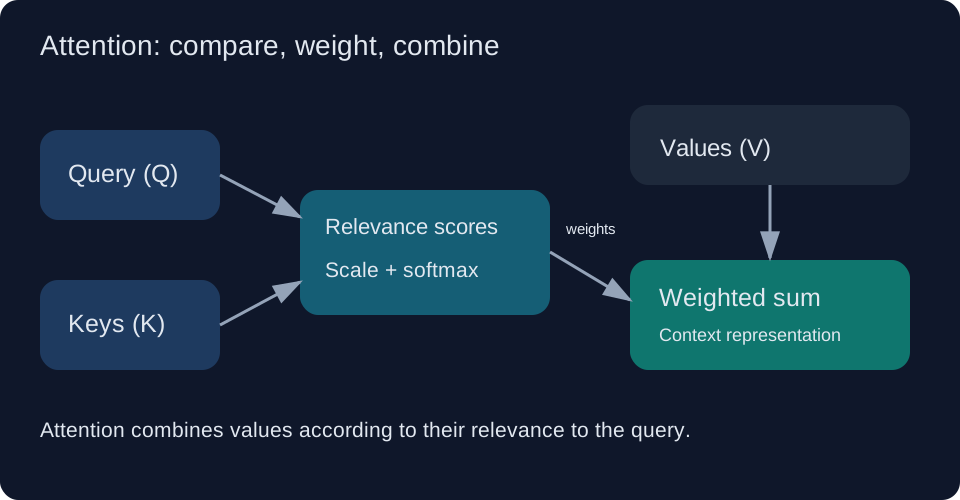
Q·K·V는 이해를 돕기 위한 이름이며, 실제 모델에서는 입력 표현을 변환한 벡터로 계산한다.
Attention은 관련도가 가장 높은 항목 하나만 고르는 것이 아니라, 여러 Value를 가중합한다. Self-Attention은 같은 입력 시퀀스에서 Q·K·V를 만들어 관계를 계산한다. Transformer는 학습 시 여러 위치를 병렬로 처리할 수 있고 BERT·GPT 등의 기반이 됐다. 다만 GPT처럼 다음 토큰을 생성하는 과정은 보통 앞서 생성한 결과에 이어 순차적으로 진행된다.
강의에서 함께 다룬 Hopfield Network는 부분적인 단서로 저장된 패턴을 떠올리는 연상 기억 모델이다. 이를 현대적으로 확장한 모델의 특정 업데이트 규칙은 Attention 연산과 수학적으로 연결된다. 기억을 검색한다는 관점에서 흥미로운 연결이지만, Transformer 전체와 고전 Hopfield Network가 같은 모델이라는 뜻은 아니다.
GAN과 Diffusion: 분류를 넘어 생성으로
GAN에는 데이터를 만드는 생성자와 실제 데이터인지 판별하는 판별자가 있다. 생성자는 판별자를 속일 만한 결과를 만들고, 판별자는 진짜와 생성된 데이터를 구분하도록 학습한다. 두 모델의 경쟁을 통해 생성 결과가 개선되는 구조다.
Diffusion은 데이터에 노이즈를 더하는 과정과 이를 제거하는 역과정을 바탕으로 한다. 학습에서는 노이즈가 섞인 데이터로부터 복원에 필요한 정보를 예측하도록 훈련하고, 생성할 때는 노이즈에서 출발해 반복적으로 정제한다. 텍스트 조건을 함께 주면 프롬프트에 맞는 결과가 나오도록 유도할 수 있다.
두 모델 모두 새로운 데이터를 생성하지만, GAN은 생성자와 판별자의 경쟁을, Diffusion은 노이즈 제거 과정을 핵심 아이디어로 삼는다.
주요 모델은 ‘핵심 아이디어’로 기억하기
| 모델 | 기억할 핵심 |
|---|---|
| 퍼셉트론 | 입력의 가중합을 임계값과 비교해 두 클래스를 구분하는 기본 신경망 모델 |
| SVM | 클래스 사이의 마진을 크게 만드는 결정경계를 학습하며, soft margin은 일부 위반을 허용 |
| CNN · LeNet | 이미지의 작은 영역에서 특징을 찾고, 이를 층별로 조합해 이미지 인식에 활용 |
| RNN · LSTM · GRU | 순서가 있는 정보를 처리하며, LSTM과 GRU는 게이트로 정보의 유지와 갱신을 조절 |
| ResNet | 입력을 출력에 더하는 연결(F(x) + x)로 깊은 신경망의 학습을 도움 |
| Transformer | Attention으로 토큰 간 관계를 학습하는 구조로, BERT·GPT 등의 기반 |
| GAN | 데이터를 만드는 생성자와 진짜·가짜를 구분하는 판별자를 경쟁시키며 학습 |
| Diffusion | 노이즈를 제거하는 과정을 학습하고, 생성 시 노이즈에서 출발해 데이터를 만듦 |
이번 강의는 규칙 기반 AI부터 데이터로 특징을 학습하는 모델, 새로운 데이터를 만드는 생성 모델까지 큰 흐름을 살펴보는 시간이었다. 다음에는 Linear Regression과 Logistic Regression에 대해 공부해보기로 한다.